ATAlign|音文对齐 / 文稿匹配,一键生成 SRT/VTT/ASS 与字级时间戳
ATAlign 是一款 Windows 本地运行 的 音文对齐(Audio-Text Alignment) 工具:把音频与对应文稿对齐到时间轴,自动生成字幕文件(SRT / VTT / ASS),并支持导出字级时间戳 JSON。常与 Z-TTS 文本转语音流程搭配使用。
最新版本
- v1.4.0.0(以下载页实际包为准)
- 更新要点:
- 新增模型
qwen-Multi-Pro:中文对齐精度更高、抗背景噪声更强,全部会员可用 - 全部模型对所有会员开放,按素材类型自由选择
- 模型目录调整为软件根目录下的
models文件夹(更新模型只需替换该目录) - CPU 版内置 ONNX 加速:检测到加速包自动启用
- 会员额度:普通会员每日 10 次 / 单条 ≥15 分钟上限;VIP 每日 50 次 / 单条 ≥90 分钟;永久 VIP 不限
- 新增运行日志:自动记录到软件目录
log文件夹 - 更新方法:因模型目录位置有变更,建议下载 v1.4.0.0 完整包;或将主程序与
models文件夹一同替换。
0. 视频教程
B 站:https://www.bilibili.com/video/BV17Q6JBDEqG/
1. 软件简介
ATAlign 基于深度学习与强制对齐(Forced Alignment),将音频内容与文本内容精准对齐到时间轴,自动生成字幕与时间戳数据。
核心功能
- 自动对齐:基于 CTC 强制对齐
- 多模型:
standard-Multi(多语言标准)、large-zh(中文高精度)、qwen-Multi-Pro(多语言高精度) - 多格式输出:SRT / VTT / ASS + JSON 字级时间戳
- 多级加速:CPU int8 / ONNX(CPU 版内置)/ NVIDIA GPU(按显卡架构选最优精度)
- 运行日志:写入软件目录
log - 批量处理:批量导入、队列处理(VIP / 永久 VIP)
- 拖放导入:音频可直接拖入任务列表
2. 使用场景(什么时候用 ATAlign)
| 场景 | 做法 | 说明 |
|---|---|---|
| Z-TTS / 在线 TTS 合成后要精修字幕 | 用合成音频 + 原文 TXT 对齐 | 旁白干净时效果最好 |
| 有声书 / 课程旁白需要 SRT | 音频与朗读稿同名配对 | 可批量(VIP) |
| 需要逐字高亮、卡拉 OK 式字幕 | 导出 JSON 字级时间戳 | 永久 VIP |
| 已有文稿、不想靠纯 ASR 听写 | 强制对齐优于“先转写再改” | 文稿必须与朗读一致 |
| 剪辑软件里字幕对不齐 | 重新对齐后覆盖旧 SRT | 先确认 TXT 无多余注释 |
不推荐
- 歌曲、带强节奏伴奏、多人叠噪的嘈杂素材
- 文稿与实际朗读差很多(错字、漏读、大量未读出的标注)
- 直接丢视频文件(请先提取音轨为 MP3/WAV)
典型工作流:
- 用 免费在线 TTS 或 Z-TTS 桌面 生成音频(可顺带导出初版字幕)。
- 准备与音频 同名 的 UTF-8
.txt文稿。 - 用 ATAlign 对齐,输出 SRT/VTT/ASS(或字级 JSON)。
- 在剪辑软件或 PotPlayer/VLC 中校验同步效果。
3. 与 Z-TTS 的关系
| 产品 | 职责 | 互补点 |
|---|---|---|
| Z-TTS | 文本 → 语音(微软 / Edge 等多接口),可导出字幕、多角色、复刻等 | 负责「生成声音」 |
| 在线 TTS 页 | 浏览器内短文本试音与即时合成 | 负责「快速试听」 |
| ATAlign | 已有音频 + 文稿 → 精确时间轴字幕 | 负责「对齐与精修字幕」 |
说明:
- Z-TTS 部分接口可在合成时直接导出 SRT,适合大多数配音场景。
- 当你需要 字级时间戳、换模型重对齐、或手头只有「成品音频 + 文稿」时,用 ATAlign 更合适。
- 网站账号可登录 ATAlign;会员等级影响次数、单条时长与输出格式(见下文权限表)。
- 不确定先用在线还是桌面合成时,见 微软 Edge TTS 在线与桌面工具怎么选。
4. 系统要求
提供 全量版(CPU+GPU) 与 CPU 专用版。
版本说明
- 全量版:体积较大,内置 GPU 组件;有 NVIDIA 显卡可加速,无显卡可降级 CPU。
- CPU 专用版:体积较小,仅 CPU;适合无独显办公机。
最低配置(CPU)
| 项目 | 要求 |
|---|---|
| 操作系统 | Windows 10/11 64 位 |
| 处理器 | Intel Core i5 8 代 / AMD Ryzen 3000 或同等(需 AVX2) |
| 内存 | 8 GB(建议 16 GB) |
| 硬盘 | ≥ 5 GB 可用(建议 SSD) |
| 显卡 | 集显即可 |
推荐配置(GPU)
| 项目 | 要求 |
|---|---|
| 操作系统 | Windows 10/11 64 位 |
| 处理器 | i7 / Ryzen 7 或更高 |
| 内存 | 16 GB 或更高 |
| 硬盘 | ≥ 10 GB(强烈建议 SSD) |
| 显卡 | NVIDIA GTX 1060 6GB 及以上 |
| 显存 | 建议 ≥ 6GB |
| 驱动 | 最新 NVIDIA 官方驱动 |
AMD / Intel 显卡暂不支持 GPU 加速,请用 CPU 版或 CPU 模式。老旧架构显卡建议 CPU 模式。
5. 安装与启动
- 下载压缩包并解压到任意目录(路径尽量不含中文和空格)
- 双击
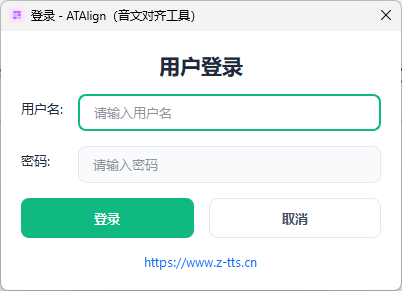
ATAlign.exe - 首次启动用 网站账号 登录(无账号请先注册)
注意:同一账号不支持重复登录,后登录会挤掉先登录。
6. 界面与操作步骤
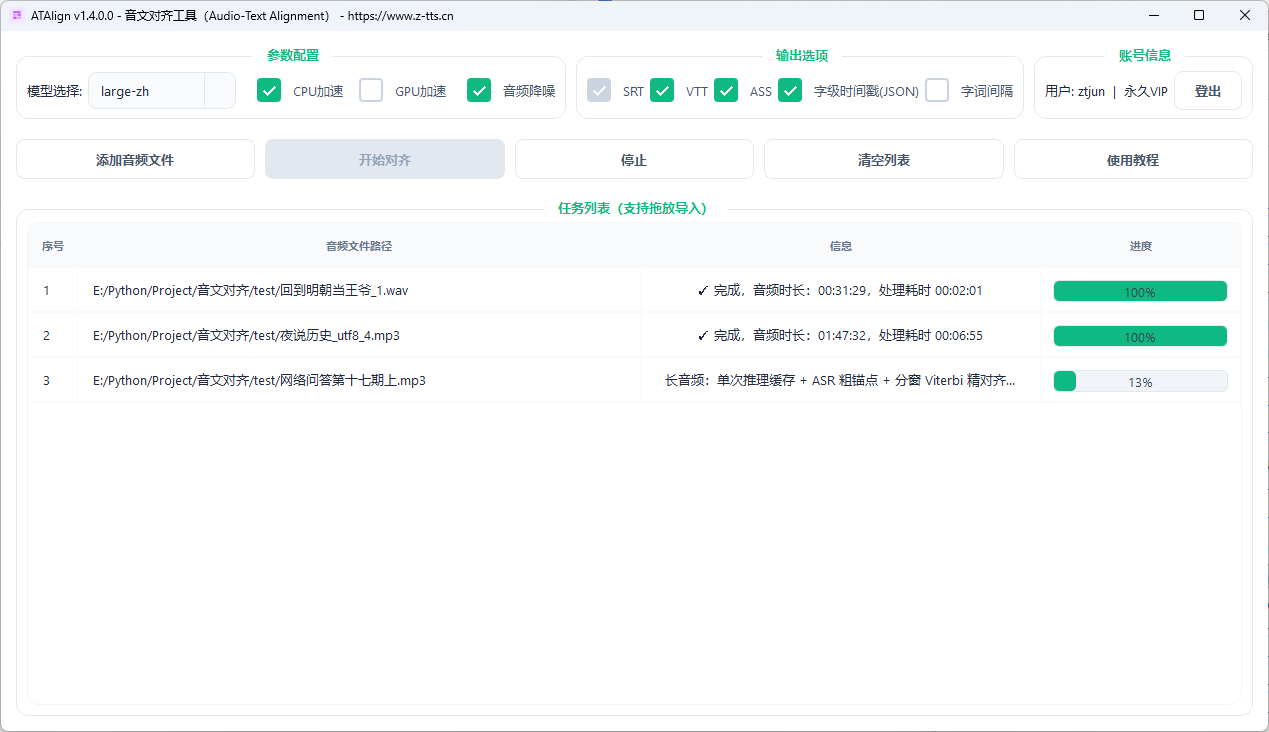
主界面大致包括:参数配置(模型、CPU/GPU 加速、降噪)、输出选项、账号信息、任务区、任务列表。
步骤 1:准备文件
- 音频:
.mp3/.wav - 文本:同名
.txt,UTF-8,内容须与朗读一致 - 命名示例:
C:\音频项目\
├── 第一章.mp3
├── 第一章.txt
├── 第二章.mp3
└── 第二章.txt
步骤 2:导入音频
点击「添加音频文件」,或拖放到任务列表。普通会员一次 1 个任务;VIP/永久 VIP 可批量排队。
步骤 3:配置选项
| 选项 | 说明 | 建议 |
|---|---|---|
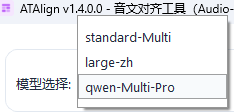
| 模型 | standard-Multi / large-zh / qwen-Multi-Pro |
中文优先 qwen-Multi-Pro 或 large-zh;英语可用 standard-Multi;小语种用 qwen-Multi-Pro |
| CPU 加速 | CPU 推理加速 | CPU 模式建议开 |
| GPU 加速 | NVIDIA 加速 | 有卡建议开 |
| 输出格式 | SRT/VTT/ASS/JSON | 普通会员仅 SRT;更高格式见会员表 |
| 音频降噪 | ffmpeg 高通+FFT | 噪声大时开;干净旁白可关 |
步骤 4:开始对齐
点击「开始对齐」,等待完成。
步骤 5:查看结果
默认在软件目录 output:
软件目录\
└── output\
    ├── 第一章.srt
    ├── 第一章.vtt
    ├── 第一章.ass
    └── 第一章.json
7. 模型、加速与批量
7.1 模型与语言
| 模型 | 支持语言(摘要) |
|---|---|
| standard-Multi | 中文、英语、日语、泰语、老挝语、缅甸语、高棉语等 |
| large-zh | 中文(简体)、英语 |
| qwen-Multi-Pro | 中、粤、英、日、韩、法、德、西、意、葡、俄(共 11 种) |
全部模型已对所有会员开放。
7.2 模型安装位置
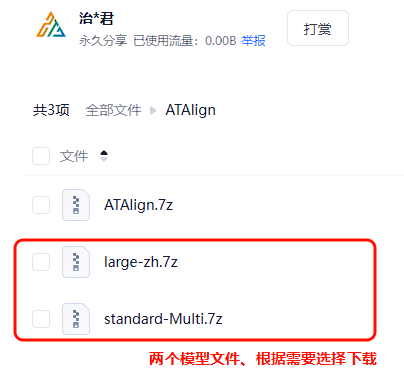
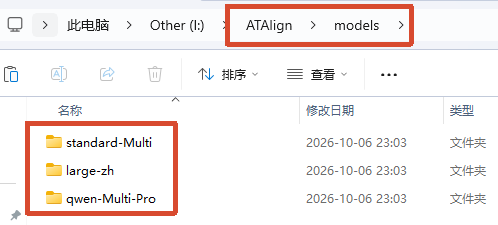
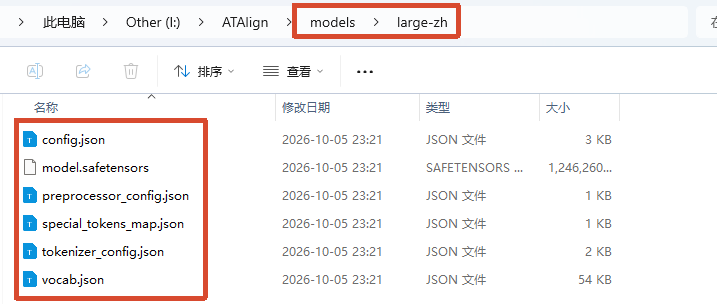
解压后将模型文件夹放到:
X:\ATAlign\models\
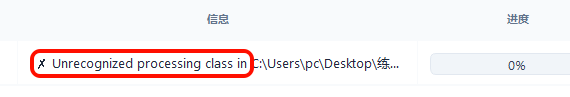
打开 large-zh 或 standard-Multi 目录应能直接看到模型文件(不要多套一层空目录)。装好后重启并登录即可加载。
7.3 加速与字词间隔
- CPU 加速:CPU 模式建议开启
- GPU 加速:需兼容 NVIDIA 与驱动;以软件检测为准
- 字词间隔:英文等需要空格分词时开启;中文一般关闭
7.4 批量处理
VIP / 永久 VIP:一次多选音频,按队列顺序处理,列表可看进度。
8. 输出格式说明
SRT
兼容性最好,多数播放器与剪辑软件支持。
1
00:00:01,500 --> 00:00:04,200
这是第一行字幕内容
VTT
适合 HTML5 / 在线平台。
WEBVTT

1
00:00:01.500 --> 00:00:04.200
这是第一行字幕内容
ASS
支持字体、颜色、位置等样式,适合进阶字幕制作。
JSON 字级时间戳
用于逐字高亮、二次开发、精细校对(永久 VIP)。
[
  {"c": "这", "start": 1.50, "end": 1.65, "score": 0.95},
  {"c": "是", "start": 1.65, "end": 1.80, "score": 0.92}
]
9. 会员权限说明
| 功能 | 普通会员 | VIP | 永久 VIP |
|---|---|---|---|
| SRT | ✓ | ✓ | ✓ |
| VTT | ✗ | ✓ | ✓ |
| ASS | ✗ | ✓ | ✓ |
| JSON 字级时间戳 | ✗ | ✗ | ✓ |
| 全部模型 | ✓ | ✓ | ✓ |
| 批量队列 | ✗ | ✓ | ✓ |
| 单日次数 | 10 | 50 | 无限 |
| 单次最大时长 | 15 分钟 | 90 分钟 | 无限 |
| CPU 加速 / 降噪 | ✓ | ✓ | ✓ |
| GPU 加速 | ✓* | ✓* | ✓* |
* GPU 以设备与驱动检测为准。升级:会员中心
10. 常见问题 FAQ
Q1:提示「对应的 .txt 文件不存在」
音频旁必须有同名 .txt;同目录、文件名一致(仅扩展名不同)、编码 UTF-8。
Q2:提示「对齐 token 数 != 可发音字符数」
文本与音频不匹配,或含未读出内容。请校对朗读一致性,删除注释/标记,确认 UTF-8,必要时缩短片段重试。
Q3:GPU 加速不可用或被取消
未检测到兼容 NVIDIA/CUDA。确认独显、更新官方驱动,或改用 CPU 加速。
Q4:处理很慢
有 NVIDIA 优先 GPU;否则开 CPU 加速;切分长音频;关闭占资源程序。
Q5:字幕时间不准
常见原因:文稿不一致、噪声大/多人声、数字读法不一致(建议「123」写成「一二三」等与实际朗读一致的写法)。
Q6:提示每日次数上限
次日按服务器时间重置,或升级会员。
Q7:闪退或启动失败
路径避免中文/特殊字符;尝试管理员运行;安装 VC++ 运行库;给杀软加信任。
Q8:登录失败 / 网络错误
检查网络与防火墙;关闭代理重试;确认账号密码。
Q9:字幕文件在哪?如何验证?
在 output;用 PotPlayer/VLC 加载字幕核对。
Q10:支持哪些语言?
中文普通话:qwen-Multi-Pro 或 large-zh;小语种:qwen-Multi-Pro;英语:三模型均可。
Q11:TXT 必须什么编码?
必须 UTF-8。记事本「另存为」选择 UTF-8。
Q12:可以直接处理视频吗?
目前仅 MP3/WAV。请先用 FFmpeg 等提取音轨。
Q13:Z-TTS 已经导出过 SRT,还需要 ATAlign 吗?
多数配音直接用 Z-TTS 字幕即可。若要对齐精度不满、需要字级时间戳、或只有成品音频+文稿,再用 ATAlign。
Q14:在线页合成的音频能对齐吗?
可以。从 免费在线 TTS 下载音频,准备同名 TXT,按本文步骤导入即可(注意在线页单次长度限制,长文建议桌面 Z-TTS)。
Q15:和「语音识别转字幕」有什么区别?
ATAlign 是 已知文稿的强制对齐,不是听写转写。文稿准确时,专名、术语正确率通常更高。
11. 相关链接
12. 技术支持
遇到无法自行排查的问题,可通过站内联系方式或用户中心工单反馈,并附上 log 目录日志与复现步骤(系统版本、软件版本、模型名、是否 GPU)。

评论(2)
我的运行出错了
联系QQ:50711698