30B 参数语音模型开放权重上线
10 月 29 日下午,英伟达发布开放权重语音模型 Nemotron 3.5 Transcribe。据 NVIDIA 介绍,模型已在 Hugging Face 和 ModelScope 上免费开放,采用 OpenMDW-1.1 许可证,单一模型即可完成 40 种语言的转写、31 种语言的翻译、13 种语言的说话人分离,并支持音频问答。处理能力上,它可应对最长一小时的录音,单条音频内最多识别 8 个说话人。
参数规模方面,第三方评测机构 Artificial Analysis 给出的数据是:总参数量 30B,激活参数 4B。MarkTechPost 的报道则将激活参数记为约 4.3B,两家对这一数字的表述存在出入。模型权重以 BF16、FP8、NVFP4 和 GGUF 四种格式发布,许可条款允许商用。
同步开源的还有数据管线 Granary v2
与模型一同公开的,是第 2 版开源语音数据集及其配套的训练数据管线 Granary v2。这意味着围绕该模型的训练数据生产流程也一并开放,而非只放出最终权重。
不过开源范围并非覆盖全部:MarkTechPost 指出,虽然权重与许可允许商用,但配套的服务优化部分尚未开源。IT 之家的报道称,量化版本预计后续发布——目前放出的是原始权重的多种精度格式,更低的量化档位仍待补齐。
评测成绩:2.8% 词错误率并列开放权重第一
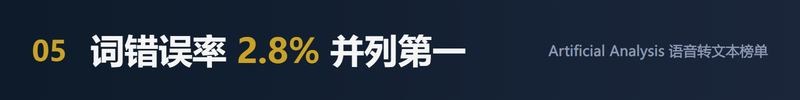
Artificial Analysis 在其非流式语音转文本榜单上测得,Nemotron 3.5 Transcribe 的词错误率为 2.8%,与 Mistral Voxtral Small 并列开放权重模型第一。
评测与使用场景之间存在一处值得留意的限制:TechCrunch 明确指出,该模型免费、开放权重,但只处理录音文件,不适用于直播流。也就是说,它的定位是非流式的离线转写,而不是实时字幕或同传类应用。
从首发到补齐报道的三天时间线
这一事件的首批报道出现在 10 月 28 日夜间。北京时间 22 时 58 分,Hugging Face 社区博客率先披露该模型及 Granary v2 数据管线的发布;23 时整,TechCrunch 报道模型支持 40 种语言;23 时 05 分,Artificial Analysis 发布评测结果,确认其 2.8% 的词错误率并列开放权重第一;23 时 49 分,The Decoder 报道该模型集成了转写、翻译和说话人识别三类能力。
10 月 29 日,报道进一步细化:12 时 41 分,MarkTechPost 补充了权重格式与约 4.3B 激活参数等细节;15 时 31 分,IT 之家报道了 40 种语言转写与 Granary v2 数据管线开源的完整信息,并提及量化版本预计后续发布。
目前该模型可在 Hugging Face 与 ModelScope 上获取,许可为 OpenMDW-1.1;服务优化部分的开源安排与量化版本的发布时间,官方尚未给出明确日期。
