月之暗面放出了 K3.1 系列的第一个模型 Kimi K3.1 Pro,按官方公布,即日起在 Kimi.com、Kimi Work、Kimi Code 和 Kimi API 上线,第三方汇总的渠道里还有 OpenRouter 和 OpenCode Go;完整权重承诺 11 月 4 日前释出。它构建在 Kimi K3 基座上,官方称后训练投入的算力大幅增加,并将其称为「迄今最强的 3T 级开放权重模型」;第三方报道给出的参数细节是 MoE 架构、总参数 2.8T、激活 104B,上下文窗口 100 万 token。官方把这一代的升级重点放在编码、3D 创作和金融研究等代理能力上,3D Make 功能已同步上线 kimi.com 与 Kimi app。同场推出的 Kimi K3.1 Pro Highspeed,速度为标准版的 2–3 倍。
成绩单:摸到第一梯队的下沿
Artificial Analysis 的综合智能指数给 K3.1 Pro 打了 55 分,排在第四,比上一代 K3 高 11 分;前面是 Claude Opus 5.5(58 分),以及 Claude Sonnet 5.5 和 Muse Wonder Full(各 56 分)。Nathan Lambert 的判断是:它已超过 Fable 5.1 与 Astra 6,若权重如期开放,将是该指数上得分最高的开放权重模型。
单项基准的分布更能说明位置,三项数据放在一起看:
- Terminal-Bench 4.0:65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%
- BenchCAD(带工具):92.7%,落后于 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%
- Code Arena WebDev:1692 分,与 Claude Opus-5 (Max) 持平,官方称成本低 70%
开放权重与头部模型的差距,更多留在带工具的 CAD 类任务上;终端类基准上,它已经能和头部模型互有胜负。官方标注的评测设置为 reasoning effort 取 max、temperature 1.0、top-p 0.95,复测时可以按同一条件对齐。
比名次更值钱的,是幻觉率的降幅
官方自测的 Kimi Hallu Bench Hard 里,claim 级幻觉率从 K3 的 23.4% 降到 8.3%,含至少一处事实错误的回复比例降为前代水平的 42.4%。内部长程编码基准 Kimi Code Bench 3.0(long-horizon)从 K3 的 55.95% 升到 61.2%;金融建模、金融研究分别比 K3 高 7.2 分和 11.6 分,商业运营类任务的成绩约为 K3 的 4.2 倍,办公文档基准 OfficeQA Pro v2 拿到 64.4 分,官方称是该基准上的最佳成绩。官方还展示了一个内部测试:模型为包含 296 块骨骼、402 组肌肉的人体模型搭建行走模拟器,把「几秒内跌倒」改进到持续交替行走 11.2 秒,期间经 167 次任务与 420 次独立评审,还纠正了肩部肌肉力臂计算里的 36 处错误。代理场景中模型自主运行的时间越长,一次幻觉的代价就越大,这类可靠性指标因此比榜单名次更能说明这代模型的实际用途。
主动削弱攻击能力,并把代价写成数字
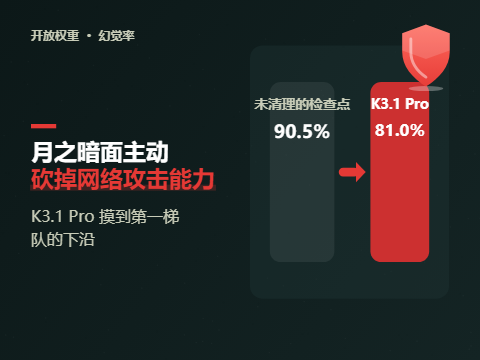
这次发布最不寻常的部分,是网络安全数据的清理。月之暗面称,随着训练规模扩大,模型的安全研究能力同步上升,来源是中训练语料和强化学习环境里混入的网络安全内容;面向开放权重的版本因此在中训练和 RL 两个阶段移除了这类数据,保留通用编码训练。代价可以量化:内部漏洞利用基准 xdev-bench-hard(pass@3)上,未清理的检查点为 90.5%,最终发布的 K3.1 Pro 为 81.0%。官方称,清理后的网络攻击能力落后于已公开至少三个月的前沿闭源模型;原则是不发布把网络攻击能力推到绝对前沿的权重,同时逐步提高开放权重的安全能力。在 Artificial Analysis 的网络安全指数上,它仍列开放可用模型第一。这套做法未必人人认同,但它把「削弱了多少」写成了可以复测的数字,而不是停留在笼统的安全表态上。
单价降了 33%,总账未必
第三方汇总的 API 报价为每百万 token 输入 2 美元、输出 10 美元、缓存命中 0.2 美元,三项均比 K3 低 33%;官方称 API 客户可选用零数据保留。不过 Lambert 同时提醒,K3.1 Pro 每次回答消耗的 token 明显更多,实际花费可能与 K3 相近。按官方说明,企业版默认关闭,需要管理员手动开启。
发布日的分数只能当参考,真正的验收在权重释出之后:外部研究者复测时,幻觉率的降幅和网络能力的削减能否与官方数字对得上,11 月 4 日这个时间点能否兑现。这两件事,比榜单第四名更能决定这代开放权重模型的成色。
